











































Rust SIMD op de GPU
GPU-code kan nu gebruikmaken van Rust's portable SIMD. We delen hier de implementatiebenadering en wat dit ontsluit voor GPU-programmering.
Bij VectorWare bouwen we aan het eerste softwarebedrijf dat volledig GPU-native is. Vandaag zijn we enthousiast om aan te kondigen dat we succesvol Rust's portable SIMD (core::simd) op de GPU kunnen gebruiken. Deze mijlpaal markeert een belangrijke stap richting onze visie: ontwikkelaars in staat stellen complexe, high-performance applicaties te schrijven die de volledige kracht van GPU-hardware benutten via vertrouwde Rust-abstracties.
Parallelisme onder het thread-niveau
Toen we Rust-threads naar de GPU brachten, koppelden we elke std::thread aan een GPU-warp. Hierdoor konden we veel gelijktijdige threads op de GPU draaien, maar we maakten geen gebruik van de parallelle lanes binnen elke thread/warp.
Op de CPU is de abstractie voor parallellisme binnen een thread SIMD (Single Instruction, Multiple Data). Eén instructie opereert op meerdere data-elementen die zijn verpakt in een vectorunit: waar scalaire code twee getallen optelt, telt een SIMD-optelling twee vectoren op (bijvoorbeeld van acht f32-waarden) en produceert in één keer acht sommen. Dit dataparallellisme vindt plaats binnen een enkele thread, onder het niveau waarop het besturingssysteem taken plant.
CPU-structuur: CPU thread → SIMD op (0, 1, 2... N) → SIMD lanes
Rust's portable SIMD
Historisch gezien betekende het schrijven van SIMD in Rust dat men gebruikmaakte van architectuur-specifieke vendor intrinsics in core::arch, zoals mm256addps op x86-64 of vaddqf32 op Arm. Deze intrinsics zijn specifiek voor één instructieset, waardoor een programma dat op meerdere architecturen draait, voor elke architectuur een aparte implementatie nodig heeft.
Rust's portable SIMD voegt in plaats daarvan een abstractielaag toe boven deze intrinsics. Het biedt één generiek type, Simd<T, N>, dat een vector van $N$ elementen van type $T$ representeert. Een programmeur schrijft de rekenkunde, vergelijkingen, reducties en lane shuffles één keer voor Simd, en de compiler vertaalt deze naar de vectorinstructies die de doel-CPU ondersteunt.
Bij VectorWare realiseerden we ons dat de GPU simpelweg een extra stuk vectorhardware is waar portable SIMD op gericht kan zijn. Als bonus bevindt portable SIMD zich in core in plaats van std, waardoor het zelfs niet de std-ondersteuning nodig heeft die wij naar de GPU hebben gebracht.
SIMT is SIMD
GPU's voeren instructies uit in een model dat NVIDIA SIMT noemt, oftewel Single Instruction, Multiple Thread. Een warp geeft één instructie uit, en elk van de 32 lanes voert die instructie uit op zijn eigen data. Eén instructie die opereert op veel data-elementen is precies wat SIMD betekent; het feit dat SIMT adressering per lane toevoegt, verandert dat niet. Een warp is in feite een brede vectorunit en een portable SIMD-vector kan direct op die unit worden geprojecteerd.
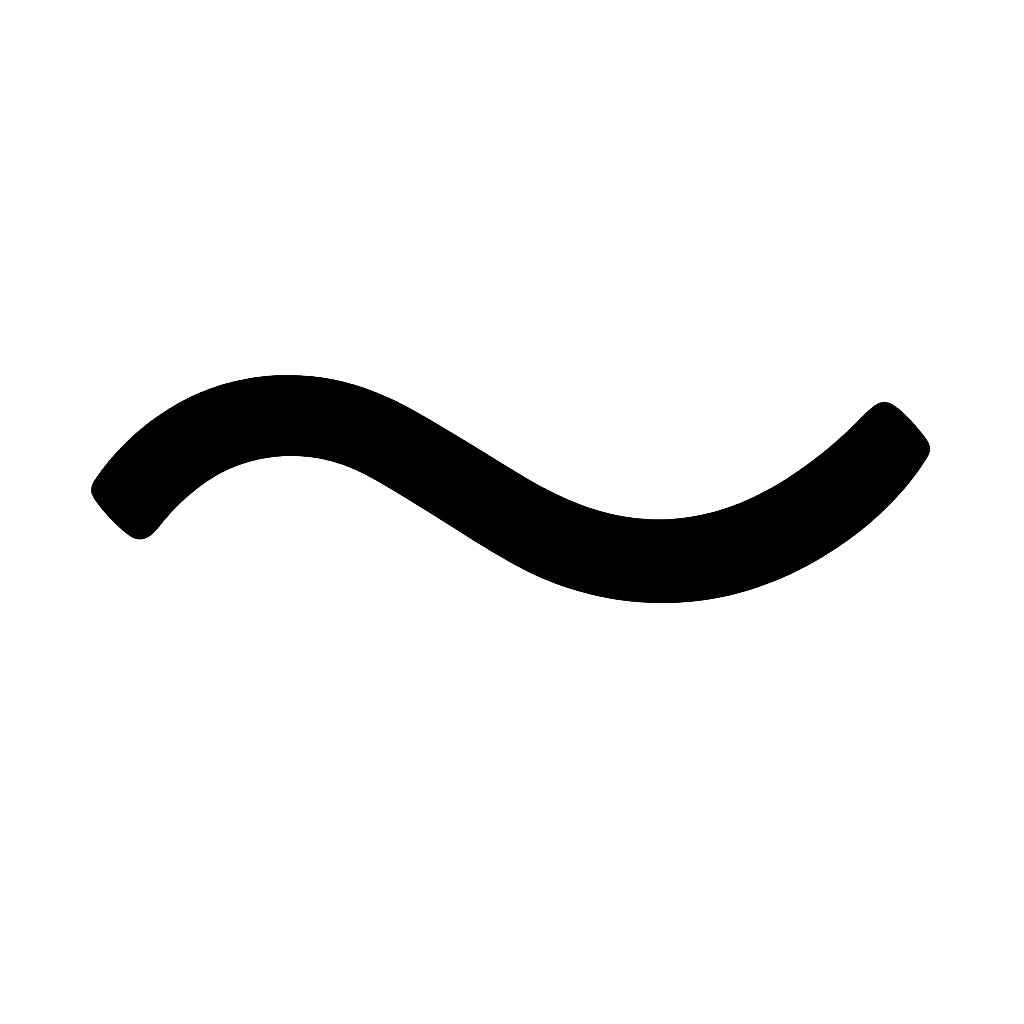
Vergelijking: CPU thread (0, 1, 2... N) lanes $\approx$ GPU warp (0, 1, 2... N) lanes
Bijvoorbeeld: een Simd<i16, 32> geeft één i16-element aan elk van de 32 lanes van de warp. Het optellen van twee dergelijke vectoren compileert naar een enkele warp-instructie waarbij elke lane zijn element tegelijkertijd optelt.
CPU-compilatie:
let a: Simd<i16, 32> = [1, 1, 1, ..., 1];
let b: Simd<i16, 32> = [2, 2, 2, ..., 2];
let c = a + b;Compileert naar: vpaddw %zmm2, %zmm1, %zmm0 (lane 0: $a0+b0$, lane 1: $a1+b1$, etc.)
GPU-compilatie:
let a: Simd<i16, 32> = [1, 1, 1, ..., 1];
let b: Simd<i16, 32> = [2, 2, 2, ..., 2];
let c = a + b;Compileert naar: add.s16 %rs3, %rs1, %rs2; (lane 0: $a0+b0$, lane 1: $a1+b1$, etc.)
Deze nieuwe mapping voltooit de parallellisme-hiërarchie uit ons eerdere werk. Op de CPU bevat een thread SIMD-lanes, en op de GPU is onze std::thread een warp waarvan de hardware-lanes dezelfde rol spelen. In beide gevallen wordt dit aangestuurd door core::simd.
Een wereldprimeur: core::simd op de GPU
Omdat de code gewoon Rust is, is dit visueel lastig te demonstreren. Dezelfde core::simd-typen die naar x86-64 SIMD compileren op een laptop, compileren naar warp-operaties op de GPU, zonder wijzigingen in de broncode.
Hieronder definiëren we een kleine portable SIMD-routine en roepen deze aan vanuit main. Dit oefent de kernfuncties van het model: elementgewijze rekenkunde, een vergelijking die een lane mask produceert, een selectie aangestuurd door dat masker, en een horizontale reductie over de lanes.
#![feature(portable_simd)]
use core::simd::cmp::SimdPartialOrd;
use core::simd::num::SimdFloat;
use core::simd::{Select, Simd};

// Portable SIMD. Deze exacte functie compileert en draait ook op de CPU,
// waar deze wordt vertaald naar x86-64, Arm of scalaire code, afhankelijk van het doel.
fn relu_dot(a: Simd<f32, 32>, b: Simd<f32, 32>) -> f32 {
    // Elementgewijze vermenigvuldiging: 32 producten worden tegelijk berekend.
    let products = a * b;

    // Vergelijking per lane produceert een masker (één boolean per lane).
    let positive = products.simd_gt(Simd::splat(0.0));

    // Behoud de positieve producten, vervang de rest door nul.
    let clamped = positive.select(products, Simd::splat(0.0));

    // Horizontale optelling over alle lanes naar één scalaire waarde.
    clamped.reduce_sum()
}

fn main() {
    // Twee vectoren van 32 breed, gebouwd met standaard Rust.
    let a = Simd::<f32, 32>::splat(2.0);
    let b = Simd::<f32, 32>::from_array(std::array::from_fn(|i| i as f32 - 16.0));

    // Elementgewijze operaties, een vergelijkingsmasker, een selectie en een reductie:
    // alles standaard portable SIMD, draaiend op de GPU.
    let result = relu_dot(a, b);

    // Geprint vanaf de GPU met onze std-ondersteuning.
    println!("relu_dot = {result}");
}Het startpunt is een normale fn main zonder GPU-specifieke annotaties. Onze toolchain compileert dit naar een GPU-kernel, en het resultaat wordt vanaf het apparaat geprint via onze std-ondersteuning.
Implementatie
Zoals eerder vermeld, rust de mapping op één observatie: een warp is een vectorunit waarvan de lanes individueel adresseerbaar zijn. Zodra Simd<T, N> per lane is ingedeeld, heeft elke familie van operaties een direct tegenhangers op warp-niveau.
- Elementgewijze SIMD-operaties: Dit is het eenvoudige geval. Optellen, vermenigvuldigen, vergelijken en andere lane-gewijze operatoren komen voort uit standaard Rust trait-implementaties op
Simd(zoalsAdd). De GPU voert deze native uit. - SIMD-reducties: Functies zoals
reducesumenreducemaxcombineren elke lane tot een scalaire waarde. Deze maken gebruik van de warp shuffle-instructies van de GPU om waarden tussen lanes uit te wisselen en te combineren, wat in elke lane hetzelfde scalaire resultaat oplevert. - SIMD cross-lane shuffles: Operaties zoals
simd_swizzle!en rotaties verplaatsen elementen tussen lanes. Omdat een SIMD-lane een GPU warp-lane is, mappen deze direct op dezelfde warp shuffle-primitieven die GPU-lanes zo efficiënt maken in het uitwisselen van data. - SIMD masks: Een
Mask<T, N>geeft één predicaat aan elke SIMD-lane.Mask::selectvoert een selectie uit in elke warp-lane. Horizontale masker-vragen zoalsanyenallmaken gebruik van GPU vote- en ballot-instructies.
Scalaire waarden in de omringende code, zoals een lus teller of een constante, worden identiek berekend door elke lane en worden dus simpelweg gerepliceerd over de warp, net als in standaard CUDA. Dit is hetzelfde onderscheid tussen uniform versus varying dat data-parallelle talen zoals ISPC expliciet maken, maar hier vloeit het voort uit de eigen typen van Rust: een gewone f32 is uniform, een Simd<f32, 32> is varying.
Werken met lanes
Het enige punt waar de abstractie en de hardware niet overeenkomen, is het aantal lanes. Op de CPU staat een Simd<T, N> elke $N$ toe van 1 tot 64, maar GPU-hardware heeft een vaste breedte: 32 lanes op NVIDIA en 32 of 64 op AMD. De mapping is één-op-één alleen wanneer $N$ overeenkomt met die breedte. Een kleinere $N$ laat sommige lanes ongebruikt, terwijl een grotere $N$ ervoor zorgt dat sommige of alle lanes meer dan één element moeten verwerken.
Wanneer er meer werk is dan de warp breed is, hebben we een manier nodig om aan te geven welke lanes wat doen. Het helpt om de warp te zien als een eigen kleine "machine": een vaste set primitieven voor het verplaatsen en combineren van data over lanes, plus invarianten over welke lanes actief zijn en hoeveel data elk bezit. "Programmeren" betekent hier het plaatsen van werk op lanes binnen deze regels.
Bij VectorWare geven we die machine een IR (Intermediate Representation). In plaats van een op zichzelf staande datastructuur, coderen we dit in het typesysteem van Rust met behulp van typen, generics, const generics en trait bounds. Een programma bestaat uit getypeerde operaties: ballots, shuffles, reductions, scans, gathers, scatters, atomics en strip mining voor vectoren die breder zijn dan de warp.
Ook operanden, uitvoeringsvorm (execution shape) en capaciteit zijn getypeerd. Omdat de operaties hun vorm in de typen dragen, kunnen veel ongeldige programma's simpelweg niet worden geconstrueerd.
De IR heeft geen interpreter op de GPU nodig. Elke operatie wordt direct vertaald naar de overeenkomstige instructies, met nul extra kosten ten opzichte van handgeschreven PTX. Dezelfde typen stellen ons in staat het ook op de CPU te draaien. We hebben een referentie-interpreter gebouwd die de IR deterministisch uitvoert—een soort Miri voor warp-lane programmering—die we gebruiken om GPU-code te simuleren en voor differential testing.
Ons werk richt zich momenteel op NVIDIA, maar niets hiervan is CUDA-specifiek. AMD wavefronts en Vulkan subgroups bieden vergelijkbare primitieven en semantiek. De IR zelf is architectuur-agnostisch Rust.
Voordelen
- Dezelfde broncode draait op zowel de CPU als de GPU. Code en bibliotheken die al gebruikmaken van portable SIMD kunnen zonder herschrijving worden uitgevoerd op de GPU.
- Ongewijzigde CPU-code kan gebruikmaken van parallellisme op GPU-lane-niveau. GPU-bewuste code kan verder gaan door
core::archintrinsics te gebruiken die direct mappen naar PTX. - Een
Simd<T, N>is een gewone owned value. De borrow checker, lifetimes en typechecking zijn hierop exact van toepassing zoals op de CPU. We voegen geen GPU-specifieke vectortypes of nieuwe annotaties toe; we mappen Rust's bestaande portable SIMD op het native uitvoeringsmodel van de GPU. Bij VectorWare zorgen we ervoor dat GPU's zich gedragen als een normaal Rust-platform.
Nadelen
- Portable SIMD is nog steeds onstabiel in Rust. Het vereist de nightly
#![feature(portable_simd)]en de interface kan veranderen voordat deze stabiliseert. - Vectoren die smaller zijn dan de warp laten lanes ongebruikt, en vectoren die breder zijn dan de warp zetten elke operatie om in meer instructies. De abstractie is alleen zero cost wanneer de vectorbreedte overeenkomt met het aantal warp-lanes.
- Niet elke cross-lane operatie mapt naar een efficiënte warp-instructie. Shuffles die overeenkomen met de ondersteunde patronen van de hardware zijn goedkoop, maar willekeurige permutaties kunnen meerdere instructies vereisen of via het shared memory moeten lopen. Horizontale operaties zoals reducties en
all/anyfungeren ook als synchronisatiepunten binnen de warp, wat beperkt hoe vrij de scheduler werk kan overlappen. - We moesten de compiler aanpassen om de abstractie sound te maken bij interactie met andere Rust-functies. Omdat dit onontgonnen terrein is, zijn we er nog niet zeker van of we alle gevallen hebben gedekt.
Toekomstig werk
Nu SIMD, threads en async allemaal op de GPU zijn gemapt, is de logische volgende stap om deze te combineren: threads die werk verdelen over warps, core::simd dat data verdeelt over de lanes binnen elke warp, en async die de concurrency daartussen structureert.
We zijn ook geïnteresseerd in het vertalen van matrix-vormige SIMD naar de tensor cores van de GPU, en in het automatisch vectoriseren van gewone scalaire Rust-lussen naar Simd-operaties, zodat code warp-level parallellisme krijgt zonder dat deze expliciet tegen core::simd geschreven hoeft te worden. Als leden van het Rust compiler-team willen we graag onderzoeken hoeveel hiervan in de compiler zelf kan gebeuren.
Een vectorrepresentatie die gedeeld wordt tussen CPU en GPU is waardevol, hoewel het niet duidelijk is of de huidige portable SIMD-typen de juiste basis hiervoor zijn. Ze staan momenteel grotendeels op zichzelf binnen de core en std API's. Hier is meer onderzoek voor nodig.
Richt VectorWare zich alleen op Rust?
De snelheid waarmee we vooruitgang boeken op de GPU is een bewijs van de kracht van Rust's abstracties en ecosysteem. Als bedrijf begrijpen we dat niet iedereen Rust gebruikt. Onze toekomstige producten zullen meerdere programmeertalen en runtimes ondersteunen. We geloven echter dat Rust uniek geschikt is voor het bouwen van high-performance, betrouwbare GPU-native applicaties, en dat is waar we het meest enthousiast over zijn.
 Groetjes,