











































Werkelijk Querybare Executables
Een korte samenvatting: SELF is een formaat waarbij het programma een SQLite-database is. We kunnen binfmt_misc gebruiken om een aangepaste interpreter aan te roepen die de rijen in de segments-tabel mapt en springt naar het instappunt (entry point). Hierdoor transformeert een hele klasse van binary tooling naar SQL.
Wat me blijft verrassen, is hoe het feit dat het bestandsformaat een SQLite-database is, alles reduceert tot SQL. Een idee dat direct duidelijk werd voor mijzelf en anderen via reacties was: als het executable een database is, en een database is iets waar je naar kunt schrijven, kan het draaiende programma dit dan ook gebruiken om zijn status (state) op te slaan?
Ja!
We kunnen niet alleen een volledige distributie, maar alle status voor elke applicatie samenvoegen in één enkel bestand. Dit maakt de noodzaak voor /var/, /tmp/, /home/ of andere bestandssystemen overbodig. Het programma kan zijn eigen status opslaan in hetzelfde bestand waarvan het wordt uitgevoerd, en dit kan transactioneel gebeuren.
self-httpd is een proof-of-concept webserver die precies dat doet. Het is een programma in één enkel bestand dat wordt uitgevoerd vanuit een database. Het bestand bevat het programma, de website, de routes en alle bezoekerslogs. Alle status wordt bijgewerkt in hetzelfde SQLite-bestand als het programma zelf.
Onze server is een enkel bestand en een SQLite-database
$ file server
server: SQLite 3.x database, application id 1397050438, ...
$ ./server --journal wal 8080
self-httpd: serving 3 routes out of /srv/self/server
self-httpd: listening on http://0.0.0.0:8080 with 4 workers
$ curl -s localhost:8080 | head -1
<!doctype html>Niemand heeft de knop op die pagina nog ingedrukt:
$ sqlite3 server 'SELECT count(*) FROM presses'
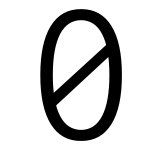
0We drukken op de knop:
$ curl -s -X POST -d press localhost:8080/api/press
{"presses":1,"button":"press"}De applicatiegegevens bevinden zich in dezelfde database:
$ sqlite3 server 'SELECT id, at, button FROM presses'
1|2026-08-25 03:11:28|pressEn dat geldt ook voor de GET-aanvraag die de pagina in eerste instantie ophaalde:
$ sqlite3 server 'SELECT count(*) AS n, path FROM visits GROUP BY path'
1|/
1|/api/pressDeze webserver is live op https://selfdb.exe.xyz. Het is één bestand, een SQLite-database, en het is tevens de server. Het is de website, het programma, het bezoekerslogboek en de status.
Alles is mijn 'demon muse'
Ik heb veel bewondering voor het werk van Justine Tunney, wiens eerdere werk redbean (een webserver in één enkel bestand, gebouwd als een Actually Portable Executable met een zelf-uitpakkend ZIP-archief) inspiratie vormde voor dit idee.
In veel opzichten is SELF minder briljant. Het vertrouwt op simpelere tools om iets vergelijkbaars te bereiken, maar ik ben versteld van hoeveel zaken samenvloeien in één domein: SQL.
Waar redbean een archiefformaat (ZIP) moet bevatten, is de database zelf bij SELF de container. redbean biedt Lua-hooks om responsen te manipuleren, terwijl het equivalent in SELF een nieuwe rij in een handlers-tabel is:
INSERT INTO handlers VALUES
('/api/busiest', 'SELECT path, count(*) FROM visits GROUP BY path ORDER BY 2 DESC LIMIT 5');Als redbean een Actually Portable Executable is, dan is dit een Actually Queryable Executable. De ene kan overal draaien, de andere kun je via een SELECT-statement bevragen.
Alles wat je nodig hebt is argv[0]
Hoe krijgt het proces toegang tot zichzelf?
Vooralsnog kun je /proc/self/exe niet gebruiken. Opmerkelijk genoeg heeft de VFS Linux-onderhoudende partij onlangs ondersteuning voor transparante binfmt_misc in de kernel doorgevoerd, wat ervoor zou zorgen dat /proc/self/exe naar het oorspronkelijke bestand wijst.
Wanneer binfmt_misc matcht, voert de kernel jouw bestand niet direct uit via execve, maar start hij de interpreter en geeft hem het pad door. self-exec geeft argv + 1 door aan het programma, waardoor de argv[0] van het programma het pad naar het executable zelf is. De interpreter sluit ook zijn SQLite-verbinding voordat hij naar het instappunt springt, zodat het programma zijn eigen bestand kan openen en bevragen.
int main(int argc, char **argv) {
    sqlite3 *db;
    /* het bestand dat de kernel zojuist heeft uitgevoerd */
    sqlite3_open(argv[0], &db);
    ...
}Dit is vrij onbeperkt en bijna magisch. Je kunt je eigen segmenttabel lezen of een nieuwe tabel ernaast maken. Schrijfacties blijven behouden over verschillende aanroepen heen.
self-httpd
De webserver voor ons voorbeeld bestaat uit drie tabellen: routes, visits en presses. We registreren elke bezoeker en elke knopdruk.
-- de inhoud, toegevoegd aan het executable
-- nadat het is gecompileerd en gelinkt
CREATE TABLE routes (path TEXT PRIMARY KEY, mime TEXT, body BLOB);

-- wat de site verzamelt, teruggeschreven
-- naar het executable terwijl het draait
CREATE TABLE visits (id INTEGER PRIMARY KEY, at TEXT, ua TEXT, path TEXT);
CREATE TABLE presses (id INTEGER PRIMARY KEY, at TEXT, button TEXT);Het bouwen van de applicatie voelt onopvallend en vertrouwd. We voeren DDL uit om het applicatieschema te maken en gebruiken INSERT voor de website.
# voorlopig een gewoon ELF-bestand
$ cc -O2 server.c -o server.elf $(pkg-config --libs sqlite3)

# hetzelfde programma, maar als rijen
$ elf2self server.elf server
$ sqlite3 server < site/schema.sql
$ sqlite3 server "INSERT INTO routes VALUES ('/index.html', 'text/html', readfile('site/index.html'))"De asset-pipeline ziet eruit als die van een "normale webserver", totdat je beseft dat hij zichzelf via SQL bevraagt voor de inhoud. En "zichzelf" is een SQLite-database.
De pagina op https://selfdb.exe.xyz toont veel leuke aanvullende informatie naast het bezoekerslogboek en de knopdrukken. Ik heb segmenten, symbolen en relocaties toegevoegd. Deze zijn niet tijdens het bouwen ingebakken, maar worden opgevraagd uit het programma zelf terwijl het draait.
Het bewerken van een live site is een transactie
Zodra je de mogelijkheid hebt om ACID-transacties uit te voeren, worden interessante dingen mogelijk. De webserver kan zijn eigen inhoud bewerken terwijl hij draait, en deze bewerkingen zijn transactioneel. De UPDATE wordt gecommit naar hetzelfde bestand als het programma, en een ROLLBACK maakt het ongedaan.
# verander de draaiende site zonder restart, reload of deploy
$ sqlite3 server "UPDATE routes SET body = readfile('new.html') WHERE path = '/index.html'"
$ curl -s localhost:8080
<!doctype html><h1>edited in place</h1>Omdat het bestandsformaat SQLite is, kunnen we ook profiteren van de enorme hoeveelheid bestaande tooling. sqldiff vertelt je precies wat een "deploy" heeft gedaan; hiermee kunnen we wijzigingen tussen twee versies van hetzelfde programma auditen en identificeren.
$ sqldiff --summary yesterday.server server
routes:      1 changes, 0 inserts, 0 deletes, 2 unchanged
segments:    0 changes, 0 inserts, 0 deletes, 13 unchanged
symbols:     0 changes, 0 inserts, 0 deletes, 174 unchanged
relocations: 0 changes, 0 inserts, 0 deletes, 99 unchangedHoe zit het met full-text search? FTS5 is slechts een CREATE VIRTUAL TABLE verwijderd, waardoor een webserver zijn eigen pagina's kan indexeren, binnen zichzelf, en daarna nog steeds een webserver blijft:
$ sqlite3 server "CREATE VIRTUAL TABLE search USING fts5(path, body);
INSERT INTO search SELECT path, body FROM routes WHERE mime LIKE 'text/%'"

$ sqlite3 server "SELECT path, snippet(search, 1, '[', ']', '...', 6)
FROM search WHERE search MATCH 'transaction'"
/index.html|...Editing is a [transaction].</h2>

# draait nog steeds, maar kent zichzelf nu beter
$ ./server 8080Niets hiervan is mechanisme dat ik zelf heb geschreven. Het is functionaliteit die SQLite al heeft, en die een programma gratis erft door een database te zijn. De hype was statische site-generators, maar de toekomst is een actually queryable executable.
Deployment is het scp'en van één bestand
Ik geniet enorm van de eenvoud die populair lijkt te worden door producten als exe.dev. Mensen verlangen vaak terug naar de "goede oude tijd" van scp en ssh om een enkel bestand te deployen, en SELF is een formaat dat dat weer mogelijk maakt, maar dan beter! In plaats van alleen een archief met PHP te versturen, versturen we het hele systeem of de applicatie-closure, tot aan de libc.
Hoe voeren we een deployment uit als de data en de code met elkaar verweven zijn? We kunnen een nieuwe deployment zien als een datamigratie, en die migratie bestaat uit twee INSERT ... SELECT-statements, omdat het programma en zijn data hetzelfde bestand zijn!
-- de huidige draaiende deployment
ATTACH '/srv/self/server' AS old;
INSERT INTO visits  (at, ua, path)
SELECT at, ua, path FROM old.visits;
INSERT INTO presses (at, button)
SELECT at, button FROM old.presses;Vervang het bestand, start opnieuw op, en het bezoekerslogboek overleeft de nieuwe build. Je kunt dit zelfs in omgekeerde volgorde voor het programma zelf doen. De segments-tabel is namelijk net als elke andere tabel.
Druk op de knop
Op https://selfdb.exe.xyz staat een knop. Het indrukken ervan is een INSERT in het executable dat je de pagina heeft geserveerd.
De code is te vinden op fzakaria/selfdb voor wie nieuwsgierig is. Het is waarschijnlijk nog wat halfbakken en zeker AI-ondersteund, maar dat is prima. Ik wilde dit idee verkennen en zien of het haalbaar was en wat er mogelijk zou zijn.
Ik denk dat ik slechts aan de oppervlakte heb geraakt van de leuke mogelijkheden. Ik ben benieuwd naar wat anderen hiermee zouden doen, en ik zou graag meer voorbeelden zien van actually queryable executables in het wild. Een idee dat een vriend suggereerde was discovery via multicase DNS om programma-updates via transacties te verspreiden.
Het blijkt dat wanneer we heroverwegen wat we beschouwden als simpelweg een byte-layout specificatie, en dit beter als een database inrichten, veel mechanismen die we decennia lang hebben gebruikt simpelweg overbodig worden. Het programma is de database, en de database is het programma.
“Never, ever underestimate the importance of having fun”
– Randy Pausch
 Groetjes,